2024-08-17 更新
2024.08.10 - 2024.08.17 更新前端面试问题总结(20 道题)
获取更多面试相关问题可以访问
github 地址: https://github.com/pro-collection/interview-question/issues
gitee 地址: https://gitee.com/yanleweb/interview-question/issues
目录:
-
初级开发者相关问题【共计 2 道题】
- 825.promise 的三种状态分别是什么, 是怎么转换的, 转换时机呢?【热度: 323】【JavaScript】【出题公司: 美团】
- 832.CSS 中隐藏元素的方法有哪些?【热度: 273】【CSS】【出题公司: 百度】
-
中级开发者相关问题【共计 10 道题】
- 815.0.1 + 0.2 不等于 0.3 这是什么原因,要怎么解决【热度: 389】【JavaScript】
- 816.[webpack] 构建过程中, 是如何将我们 es6 代码 编译为 es5【热度: 420】【工程化】【出题公司: TOP100 互联网】
- 817.[React] 类组件里面 setState 做了哪些事儿【热度: 200】【web 框架】【出题公司: TOP100 互联网】
- 821.【git] 如何移除一个指定的 commit【热度: 762】【web 应用场景】【出题公司: 阿里巴巴】
- 826.js 数据类型里面,Map 和 object 分别有哪些适用场景,开发中该如何抉择【热度: 395】【JavaScript】【出题公司: 美团】
- 827.对象的遍历方式有哪些【热度: 848】【JavaScript】【出题公司: PDD】
- 828.[vue] 第一次页面加载会触发哪几个钩子【热度: 112】【web 框架】【出题公司: 网易】
- 829.JS 脚本延迟加载的方式有哪些?【热度: 156】【JavaScript】【出题公司: 腾讯】
- 830.node 里面可以使用 es module 吗【热度: 187】【Nodejs】【出题公司: 腾讯】
- 833.[git] 将多次提交压缩成一次提交【热度: 412】【web 应用场景】【出题公司: 百度】
-
高级开发者相关问题【共计 8 道题】
- 818.[React] useState 的原理是什么,背后怎么执行的【热度: 446】【web 框架】【出题公司: TOP100 互联网】
- 819.[React] 为什么要自定义合成事件【热度: 132】【web 框架】【出题公司: TOP100 互联网】
- 820.手写瀑布流布局【热度: 551】【JavaScript】【出题公司: 阿里巴巴】
- 822.【git] 当项目报错,你想定位是哪个 commit 引入的错误的时候,该怎么做【热度: 650】【web 应用场景】【出题公司: 阿里巴巴】
- 823.axios 是否可以缓存请求返回值到内存里面,下次调用的时候,直接使用内存中的缓存数据?【热度: 884】【网络】【出题公司: 腾讯】
- 824.手写一个 axios 中间件,支持缓存返回到本地内存【热度: 845】【网络】【出题公司: 腾讯】
- 831.在低版本的 node 中想使用 es module 该如何做?【热度: 188】【Nodejs】【出题公司: 腾讯】
- 834.实现一个函数,支持深度遍历 JS 对象,且允许再遍历的时候,修改对象的数据,得到新的对象【热度: 441】【JavaScript】【出题公司: 百度】
825.promise 的三种状态分别是什么, 是怎么转换的, 转换时机呢?【热度: 323】【JavaScript】【出题公司: 美团】
关键词:promise 状态
Promise 在 JavaScript 中是一种非常有用的异步编程构造,它代表了一个可能现在、将来或永远都不会完成的操作的结果。每个Promise对象都会经历以下三种状态之一:
- Pending (待定): 这是
Promise的初始状态,表示异步操作尚未完成,也尚未失败。 - Fulfilled (已兑现): 表示与
Promise相关联的异步操作已成功完成。 - Rejected (已拒绝): 表示与
Promise相关联的异步操作已失败。
-
从 Pending 到 Fulfilled:
- 当异步操作成功完成时,调用
resolve()函数,此时 Promise 的状态会从Pending变为Fulfilled。 - 这时
.then()方法中注册的成功处理函数(如果有的话)会被调用。
- 当异步操作成功完成时,调用
-
从 Pending 到 Rejected:
- 当异步操作失败或出现错误时,调用
reject()函数,此时 Promise 的状态会从Pending变为Rejected。 - 这时
.catch()方法中注册的失败处理函数(如果有的话)会被调用。
- 当异步操作失败或出现错误时,调用
一旦Promise的状态从Pending变为Fulfilled或Rejected,它就不能再变为任何其它状态,即Promise的状态是不可逆的。相应地,resolve和reject函数也只能有效地各自调用一次;额外的调用将被忽略。
Promise状态的转换时机取决于异步操作何时完成或失败。- 使用
resolve()或reject()函数明确地标记异步操作的成功或失败。 - 调用
resolve()后,所有挂在该Promise上的.then()中成功处理函数将被异步调用。 - 调用
reject()后,所有挂在该Promise上的.catch()中失败处理函数将被异步调用。
下面是一个简单的Promise示例,它演示了如何创建Promise,以及Promise的状态如何从Pending转变为其他状态:
let promise = new Promise((resolve, reject) => {
// 异步操作
setTimeout(() => {
const success = true; // 假设这是根据异步操作结果而定的逻辑
if (success) {
resolve("Operation successful"); // 从 Pending 到 Fulfilled
} else {
reject("Operation failed"); // 从 Pending 到 Rejected
}
}, 1000);
});
// 监听 Promise 的结果
promise.then(
(value) => console.log(value), // 成功处理函数
(error) => console.log(error) // 失败处理函数
);在这个示例中,setTimeout模拟了异步操作,success变量代表操作是否成功。根据success的值,promise的状态会相应地转换成Fulfilled或Rejected。
832.CSS 中隐藏元素的方法有哪些?【热度: 273】【CSS】【出题公司: 百度】
关键词:CSS 隐藏元素
在 CSS 中,隐藏元素可以通过多种方式实现,每种方式有其特定的使用场景。这里列出了一些常用的方法:
完全移除元素,使其不占据任何空间,也不会在文档流中占位。元素及其所有子元素都不会显示。
.element {
display: none;
}使元素不可见,但它仍然占据原来的空间和位置。与 display: none; 不同,visibility: hidden; 不会影响文档流的布局。
.element {
visibility: hidden;
}设置元素透明度为 0,使其完全透明。元素仍然占据空间,并且可以与之互动(例如,点击),除非你另外禁用了元素的互动能力。
将元素移出视图区域,例如设置一个非常大的负边距。
.element {
position: absolute;
left: -9999px;
}或者使用 top 或 bottom,将其定位到视窗外部。
通过剪裁,使元素的某些部分不可见。clip-path 可以更灵活地定义哪些部分可见。
.element {
clip-path: circle(0);
}6. overflow: hidden; 与尺寸设置
设置元素宽高为 0,并设置 overflow 为 hidden,这将隐藏元素内容。
.element {
width: 0;
height: 0;
overflow: hidden;
}7. 将元素的 height 或 width 设置为 0 并结合 overflow: hidden
如果你还想保留某些边框或轮廓的样式,可能希望使用 width 和 height 为 0 的方法,加上 overflow: hidden 防止内容外泄。
.element {
width: 0;
height: 0;
overflow: hidden;
}- 从 DOM 中完全移除元素:
display: none;适合完全从文档流中移除元素的场景。 - 仍需要保留位置:
visibility: hidden;适合需要隐藏元素但保留其占位的场景。 - 逐渐隐藏:
opacity: 0;适合需要渐变动画效果的场景。 - 临时移除视野或隐藏内容的特定部分:使用定位或
clip-path方法。
815.0.1 + 0.2 不等于 0.3 这是什么原因,要怎么解决【热度: 389】【JavaScript】
关键词:精度计算
在 JavaScript 中,0.1 + 0.2 不等于 0.3 的原因是浮点数的精度问题。
在计算机中,浮点数采用二进制存储,而有些十进制小数无法精确地用二进制表示。0.1 和 0.2 在二进制表示中是无限循环的,在进行运算时会产生舍入误差。
要解决这个问题,可以使用以下方法:
- 使用
Number.EPSILON来比较两个浮点数是否接近:
function numbersAreCloseEnough(num1, num2) {
return Math.abs(num1 - num2) < Number.EPSILON;
}
let result = 0.1 + 0.2;
console.log(numbersAreCloseEnough(result, 0.3));- 将浮点数乘以一个适当的倍数转换为整数进行计算,计算完成后再除以这个倍数转换回浮点数:
let num1 = 0.1 * 10;
let num2 = 0.2 * 10;
let sum = (num1 + num2) / 10;
console.log(sum === 0.3);- 使用第三方库,如
decimal.js,它提供了更精确的十进制运算:
const Decimal = require("decimal.js");
let num1 = new Decimal("0.1");
let num2 = new Decimal("0.2");
let sum = num1.plus(num2);
console.log(sum.eq(0.3));这些方法可以帮助您在处理浮点数运算时更准确地得到预期的结果。
816.[webpack] 构建过程中, 是如何将我们 es6 代码 编译为 es5【热度: 420】【工程化】【出题公司: TOP100 互联网】
关键词:es6 编译为 es5
Webpack 本身是一个模块打包器(bundler),它并不直接负责将 ES6 代码编译为 ES5 代码。Webpack 的主要功能是将项目中的所有模块(JavaScript、图片、CSS 等)打包成一个或多个 bundle,以供浏览器加载。然而,Webpack 可以通过加载器(loaders)和插件(plugins)来扩展其功能,实现代码的转换和编译。
将 ES6 代码编译为 ES5 的过程通常涉及以下几个步骤:
-
Babel 转换: Babel 是一个流行的 JavaScript 编译器,可以将 ES6+ 代码转换为向后兼容的 JavaScript 版本,即 ES5。Webpack 可以与 Babel 配合使用,通过 Babel Loader 来实现代码的转换。
-
Loader 配置: 在 Webpack 配置中,你可以指定使用 Babel Loader 来处理
.js文件。当 Webpack 处理 JavaScript 文件时,Babel Loader 会被调用,并将 ES6 代码转换为 ES5。// webpack.config.js module.exports = { // ... module: { rules: [ { test: /\.js$/, use: { loader: "babel-loader", options: { presets: ["@babel/preset-env"], }, }, }, ], }, // ... }; -
Babel 预设: Babel 使用预设(presets)来定义转换规则。
@babel/preset-env是一个常用的预设,它会自动配置 Babel 以兼容目标浏览器的版本。 -
Polyfills: 为了支持旧浏览器,Babel 还可以引入 polyfills,这些是提供现代 JavaScript 特性的第三方代码片段。例如,
core-js和regenerator-runtime是两个常用的 polyfill 库。 -
转换过程:
- 解析:Babel 首先解析 ES6 代码为 AST(抽象语法树)。
- 转换:然后,Babel 遍历 AST,将 ES6 语法转换为 ES5 语法。
- 生成:最后,Babel 生成新的 ES5 代码。
-
Tree Shaking: Webpack 支持 Tree Shaking,这是一种去除未使用代码的技术,可以进一步减小最终打包文件的大小。
-
代码分割: Webpack 还可以进行代码分割,将代码拆分成多个 chunk,按需加载,提高应用的加载性能。
-
优化: Webpack 还提供了多种优化选项,如压缩代码、合并模块等,以减小最终输出文件的大小。
总结来说,Webpack 本身不直接编译 ES6 代码为 ES5,**而是通过与 Babel 等工具的配合使用,实现代码的转换和编译。Webpack 的主要作用是模块打包,而 Babel 负责将现代 JavaScript 代码转换为广泛兼容的格式。**通过合理配置 Webpack 和 Babel,可以高效地构建和优化前端应用。
817.[React] 类组件里面 setState 做了哪些事儿【热度: 200】【web 框架】【出题公司: TOP100 互联网】
关键词:setState 做了哪些事儿
在 React 的类组件中,setState 方法主要做了以下几件事情:
-
触发组件的重新渲染:当调用
setState时,React 会标记该组件为“脏”状态,在下一个渲染周期中重新渲染组件。 -
合并状态更新:
setState接受一个对象或函数作为参数。如果是对象,它会与当前组件的状态进行合并。如果是函数,该函数会接收当前的状态作为参数,并返回一个新的状态对象,然后与当前状态合并。 -
异步更新:在大多数情况下,
setState是异步执行的,这是为了优化性能,避免不必要的频繁渲染。但在某些特殊情况下,如在事件处理函数中,可以通过给setState传递一个函数作为第二个参数来在状态更新完成后执行一些操作。
例如:
class MyComponent extends React.Component {
constructor(props) {
super(props);
this.state = { count: 0 };
}
handleClick = () => {
// 方式一:对象形式
this.setState({ count: this.state.count + 1 });
// 方式二:函数形式
this.setState((prevState) => ({ count: prevState.count + 1 }));
};
}821.【git] 如何移除一个指定的 commit【热度: 762】【web 应用场景】【出题公司: 阿里巴巴】
关键词:commit 移除
移除某一个指定的 commit 通常意味着要在版本控制系统如 Git 中更改历史记录,这通常涉及到一些操作风险,尤其是当这个 commit 已经被推送到远程仓库且被其他人使用。下面是几种常见的移除指定 commit 的方法,但在进行这些操作前,请确保备份你的代码,以防不测:
- 打开终端或命令行界面。
- 定位到你的 Git 项目路径下。
- 执行
git rebase -i HEAD~X命令,X是从当前回到你想要移除的commit的数量加 1。这条命令会打开一个交互式界面,列出最近的X次提交。 - 找到你想要移除的
commit,并将其前面的pick改为drop。或者干脆删除那一行。 - 保存并关闭编辑器,Git 会自动开始 rebase 进程。
如果你仅仅是想移除最近的一次提交,可以这样做:
- 使用命令
git reset --soft HEAD~1将最后一次提交回退到暂存状态,不影响工作目录。 - 使用命令
git reset --hard HEAD~1将最后一次提交完全撤销,包括工作目录和暂存区的改变。
- 修改已经被推送到远程仓库的历史是非常危险的,如果其他人已经基于这些提交做了开发,这将引起合并冲突。
- 如果你需要修改已经推送过的提交,完成上述操作后,需要使用
git push --force来强制推送到远程仓库,这样也会影响到其他协作者的开发进程。
826.js 数据类型里面,Map 和 object 分别有哪些适用场景,开发中该如何抉择【热度: 395】【JavaScript】【出题公司: 美团】
在 JavaScript 中,Map和普通的对象(Object)都可以用作键值对的集合,但它们各自的特性和使用场景有所不同。根据这些特性和场景,你可以选择最适合你需求的数据结构。
特性:
- 键(key)必须是字符串或符号(
Symbol)。 - 适合少量和简单数据结构的场景,以及当你知道键集合不会经常变化时。
- 对象字面量语法简洁,易于创建和操作。
- 部分现代 JavaScript 引擎对对象进行了优化,在访问已知键和枚举属性时表现良好。
适用场景:
- 当键是简单字符串时。
- 需要将数据结构序列化为 JSON 时(
Map不支持直接序列化)。 - 当利用对象在原型链上提供方法时,例如
.toString()。 - 当要利用存在的库和框架 API,这些 API 期望传入对象时。
特性:
- 键可以是任意值,包括对象。
- 保留了键值对的插入顺序。
- 可以容易地获取其大小(
Map.prototype.size属性)。 - 更加适合频繁增删键值对的场景。
- 直接的迭代支持,
Map有.keys(),.values(), 和.entries()方法,以及可以直接被 for...of 循环迭代。
适用场景:
- 键的集合是动态的,频繁增加或删除键值对。
- 键不仅仅是字符串或符号,可能是对象或其他复杂类型。
- 需要保持键值对的插入顺序。
- 当集合大小经常变化且需频繁读取大小时。
- 需要高性能的迭代操作。
选择Map还是Object主要取决于你的具体应用场景:
- 静态和可序列化的键值对集合:如果你需要一个简单的数据结构来表示静态的键值对集合,且可能需要将这个集合序列化为 JSON,那么普通对象可能更适合你的需求。
- 动态或复杂的键值对集合:如果你需要存储复杂类型的键,或者你的键值对集合需要频繁更新(添加/删除键值对),同时需要保留插入顺序,那么
Map将是更好的选择。
通常,Map在处理复杂、动态或大量的键值对数据时提供了更好的灵活性和性能。然而,在简单的场景下,或当需要利用 JSON 进行序列化、反序列化时,使用普通的对象可能更方便和直观。
827.对象的遍历方式有哪些【热度: 848】【JavaScript】【出题公司: PDD】
关键词:对象遍历方式
遍历 JavaScript 对象的属性可以使用几种不同的方法,每种方法都有其适用场景和特点。以下是一些常用的遍历对象属性的方法:
for-in 循环可以遍历一个对象的所有可枚举属性,包括其原型链上的属性。
const obj = { a: 1, b: 2, c: 3 };
for (const key in obj) {
if (obj.hasOwnProperty(key)) {
// 推荐检查属性是否为对象本身的属性
console.log(key, obj[key]);
}
}使用 hasOwnProperty 方法检查属性是否是对象本身的属性(而不是继承的属性)是一个好习惯。
Object.keys() 方法返回一个包含对象自身所有可枚举属性名称的数组。
const obj = { a: 1, b: 2, c: 3 };
Object.keys(obj).forEach((key) => {
console.log(key, obj[key]);
});Object.values() 方法返回一个包含对象自身所有可枚举属性值的数组。
const obj = { a: 1, b: 2, c: 3 };
Object.values(obj).forEach((value) => {
console.log(value);
});Object.entries() 方法返回一个给定对象自身可枚举属性的键值对数组。
const obj = { a: 1, b: 2, c: 3 };
Object.entries(obj).forEach(([key, value]) => {
console.log(key, value);
});5. Object.getOwnPropertyNames()
Object.getOwnPropertyNames() 方法返回一个数组,包含对象自身的所有属性(不论属性是否可枚举),但不包括 Symbol 属性。
const obj = { a: 1, b: 2, c: 3 };
const propertyNames = Object.getOwnPropertyNames(obj);
propertyNames.forEach((name) => {
console.log(name, obj[name]);
});Reflect.ownKeys() 方法返回一个数组,包含对象自身的所有键,包括字符串键和Symbol 键。
const obj = { a: 1, b: 2, c: 3, [Symbol("d")]: 4 };
Reflect.ownKeys(obj).forEach((key) => {
console.log(key, obj[key]);
});根据需要选择合适的方法进行对象属性的遍历。例如,当你想要同时获取属性的键和值时,Object.entries() 是一个很好的选择。而如果你想要包括 Symbol 属性在内的所有键,那么 Reflect.ownKeys()可能是更合适的选择。
828.[vue] 第一次页面加载会触发哪几个钩子【热度: 112】【web 框架】【出题公司: 网易】
关键词:vue 钩子出发
在 Vue.js 中,页面首次加载时,会按照以下顺序触发一系列的生命周期钩子:
-
beforeCreate: 实例刚在内存中被创建时调用,此时还未初始化响应式数据和事件。
-
created: 实例创建完成后被调用,此时已完成数据观测(即数据响应式)、属性和方法的运算,
$el属性还未显示出来。 -
beforeMount: 在挂载开始之前被调用,相关的
render函数首次被调用。此时$el属性还未被创建。 -
mounted:
el被新创建的vm.$el替换,并挂载到实例上去之后调用该钩子。如果根实例挂载了一个文档内元素,当mounted被调用时,组件已经在文档内。
在这个过程中,beforeCreate 和 created 钩子在服务端渲染过程中也会被调用,而 beforeMount 和 mounted 只会在客户端被调用。需要特别注意的是,mounted 不会保证所有的子组件也都一起被挂载。如果你希望等待整个视图都渲染完毕,可以在 mounted 钩子内部使用 Vue.nextTick 或 vm.$nextTick。
简而言之,首次加载页面时,Vue 会按顺序触发 beforeCreate, created, beforeMount, 和 mounted 生命周期钩子。这些钩子提供了在不同阶段介入组件行为的机会,使得我们可以执行如访问数据、修改 DOM 等操作。
829.JS 脚本延迟加载的方式有哪些?【热度: 156】【JavaScript】【出题公司: 腾讯】
关键词:JS 延迟加载、JS 异步加载
JavaScript 脚本的延迟加载是一种优化网页加载时间的技术,可以提高页面的加载速度,提升用户体验。以下是常见的几种 JS 脚本延迟加载的方式:
1. 使用 <script> 标签的 defer 属性
在 <script> 标签中使用 defer 属性可以使得脚本在文档解析完成后,但在 DOMContentLoaded 事件触发之前执行。defer 属性仅适用于外部脚本。
<script src="path/to/your-script.js" defer></script>2. 使用 <script> 标签的 async 属性
与 defer 类似,async 属性使得脚本在加载时不会阻塞 HTML 文档的解析,但它与 defer 的区别在于,脚本一旦下载完成就会立即执行,而不是等到整个页面都解析完毕。这意味着 async 脚本的执行顺序是不确定的。
<script src="path/to/your-script.js" async></script>可以通过 JavaScript 动态创建 <script> 标签并插入到文档中,以此来延迟加载脚本。
var script = document.createElement("script");
script.src = "path/to/your-script.js";
document.body.appendChild(script);4. 使用加载器库(如 RequireJS、SystemJS)
现代 JavaScript 项目中,可以使用模块加载器(如 RequireJS 或 SystemJS)来实现对脚本及其依赖的异步加载。
require(["path/to/your-module"], function (module) {
// 使用模块
});5. 利用 IntersectionObserver
IntersectionObserver API 允许你配置一个回调,当监测到指定元素进入或离开视口时触发。通过这种方式,可以在元素即将出现在视图中时,动态加载相应的脚本。
let observer = new IntersectionObserver(
(entries, observer) => {
entries.forEach((entry) => {
if (entry.isIntersecting) {
// 元素现在可见,加载脚本
var script = document.createElement("script");
script.src = "path/to/your-script.js";
document.head.appendChild(script);
}
});
},
{ rootMargin: "0px 0px 0px 0px" }
);
observer.observe(document.querySelector(".some-element"));服务端渲染 (SSR) 或服务器端动态渲染技术(如用 Node.js 配合框架 Next.js、Nuxt.js 等)也可以实现对特定条件下的脚本延迟加载。
各个技术方案适用的场景不同,选择合适的延迟加载方式可以大幅改善网页的性能和用户体验。
830.node 里面可以使用 es module 吗【热度: 187】【Nodejs】【出题公司: 腾讯】
关键词:node 使用 es module
是的,从 Node.js 的较新版本开始,你可以在 Node.js 中使用 ES Modules(ESM)。
要在 Node.js 中使用 ES Modules,你可以采取以下几种方式之一:
-
使用
.mjs扩展名: 你可以将你的模块文件保存为.mjs文件。Node.js 会将.mjs文件自动识别为 ES Modules。你可以直接使用import和export语法。 -
在
package.json中设置"type": "module": 如果你更倾向于使用.js扩展名,你可以在package.json文件中添加"type": "module"。这会使得 Node.js 将.js文件当作 ES Modules 来处理。注意,这样设置后,如果你需要使用 CommonJS 模块,那么 CommonJS 文件必须采用.cjs扩展名。
这样,你的 .js 文件中就可以使用 import 和 export 语句了。
补充知识 - node 是从什么时候开始支持 esm 的?
Node.js 对 ES Modules (ESM) 的支持始于 Node.js 8.5.0(发布于 2017 年 9 月),但当时这一特性处于实验阶段,使用时需要通过 --experimental-modules 标志来启用。
Node.js 12 版本(具体地,12.17.0 及更高版本)中,ES Module (ESM) 支持进入了稳定状态,使得开发者可以在不需要任何标志的情况下直接使用 ESM。
随后的 Node.js 版本继续改进和增强对 ESM 的支持,包括改善与 CommonJS 模块互操作性等方面,从而提供更加稳定和完整的模块系统支持。
因此,如果您想使用不需要任何实验性标志的 ESM,应该使用 Node.js 12.17.0 或更高的版本。但要获得最佳的支持和最新的功能,推荐使用 Node.js 的最新稳定版本。
- 当使用 ES Modules 时,
import语句必须使用完整的文件路径,包括文件扩展名,或者指向存在package.json的模块。这与 CommonJS 的require()有所不同,后者可以省略文件扩展名。 - 在使用 ES Modules 时,一些 Node.js 的全局变量和方法有所不同,比如,代替
__dirname和__filename,你可能需要通过import.meta.url来获取当前文件的 URL。 - 如果你的项目中同时使用了 ES Modules 和 CommonJS 模块,需要注意模块间的导入导出兼容性问题。
截止到我的知识更新日期(2023 年 4 月),Node.js 已经良好地支持 ES Modules,并且社区和生态系统也在不断地改进和适配这一新特性。实际使用中,应当关注你所使用的 Node.js 版本文档,查看关于 ES Modules 的最新支持情况和最佳实践。
833.[git] 将多次提交压缩成一次提交【热度: 412】【web 应用场景】【出题公司: 百度】
关键词:多次提交压缩成一次提交
将多次提交压缩成一次提交在 Git 中被称为“squash”。这通常在你完成一段工作后,想要将这段时间内的多个提交整理为一个更干净、更整洁的提交记录时使用。Git 提供了几种方法来实现提交的压缩,最常用的是通过 git rebase 命令配合交互模式(interactive mode)来实现。
假设你想压缩最近的 N 次提交。首先,你需要确定从哪个提交开始进行操作。可以通过 git log 查看提交历史,然后选择你想要压缩的提交的前一个提交作为起点。
-
启动交互式 rebase 会话:
其中
N是你想要压缩的提交数量。例如,如果你想要压缩最近的 3 次提交,你应该使用git rebase -i HEAD~3。 -
编辑 rebase 会话中出现的命令列表:
执行上述命令后,你的默认文本编辑器会打开一个带有待压缩提交列表的文件。这些提交被列出来,前面默认是
pick命令。pick e3a1b35 第一次提交的消息 pick 7ac9a67 第二次提交的消息 pick 1d2a3f4 第三次提交的消息将除了第一个提交之外的所有
pick命令改为squash或简写s,表示这些提交将被压缩到前一个提交中。pick e3a1b35 第一次提交的消息 squash 7ac9a67 第二次提交的消息 squash 1d2a3f4 第三次提交的消息 -
保存并退出编辑器:
一旦保存并关闭编辑器,Git 将开始 rebase 过程,并可能会要求你解决任何合并冲突。然后,它会打开你的文本编辑器,让你编辑最终的提交消息。默认情况下,这会包含你压缩的所有原始提交消息。
-
完成 rebase 过程:
解决完所有冲突(如果有的话)并保存你的最终提交消息之后,你可以完成 rebase 过程。
-
推送更改到远端仓库(如果需要):
如果你已经将提交推送到了远端仓库,你可能需要使用
--force参数来强制推送更改,但请注意,这可以覆盖远端仓库的历史,因此仅在确保不会影响他人工作的情况下使用。git push origin your-branch-name --force
通过这种方法,你可以将多个提交压缩成一个更整洁的提交,以保持项目历史的清晰。
818.[React] useState 的原理是什么,背后怎么执行的【热度: 446】【web 框架】【出题公司: TOP100 互联网】
关键词:useState 的原理
useState 是 React 库中的一个 Hook,它允许你在函数组件中添加 React 状态。使用 useState,你可以给组件添加内部状态,并且能够通过调用这个 Hook 来更新状态,从而触发组件的重新渲染。
useState 的工作原理基于 React 的渲染机制和 Fiber 架构。以下是 useState 工作流程的简要概述:
-
初始化状态:当你在函数组件中调用
useState时,React 会为该组件创建一个状态变量。如果提供了初始值,状态将被初始化为该值。 -
返回更新函数:
useState返回一个数组,包含当前的状态值和一个更新该状态的函数(通常命名为setState)。 -
调用更新函数:当你调用这个更新函数并传入一个新的状态值时,React 会将这个新的状态值与当前状态合并,并计划重新渲染组件。
-
重新渲染:在下一次的渲染周期中,React 会使用新的状态值重新渲染组件。
-
状态持久化:React 通过内部机制确保状态在组件的多次渲染之间保持不变。
以下是 useState 在 React 内部可能的执行过程:
-
调用 useState:在函数组件中调用
useState(initialState)。 -
创建状态对象:React 创建一个状态对象,存储状态值和与之关联的更新函数。
-
渲染组件:使用当前的状态值渲染组件。
-
更新状态:当组件需要更新状态时,调用由
useState返回的更新函数,例如setState(newState)。 -
调度更新:React 将更新调度到下一个渲染周期,并标记组件为需要重新渲染。
-
批量处理:React 可能会将多个状态更新批处理在一起,以避免不必要的多次渲染。
-
重新渲染组件:在下一个渲染周期,React 使用新的状态值重新渲染组件。
-
状态持久化:React 的状态持久化机制确保即使在组件卸载和重新挂载后,状态也能被正确地恢复。
import React, { useState } from "react";
function Counter() {
const [count, setCount] = useState(0); // 初始化状态为 0
return (
<div>
<p>Count: {count}</p>
<button onClick={() => setCount(count + 1)}>Increment</button>
</div>
);
}在这个例子中,useState 被用来初始化 count 状态,并提供了一个 setCount 函数来更新它。每次点击按钮时,setCount 被调用,React 计划重新渲染组件,并在下一次渲染周期中使用新的状态值。
819.[React] 为什么要自定义合成事件【热度: 132】【web 框架】【出题公司: TOP100 互联网】
关键词:React 合成事件
React 选择自定义合成事件系统主要是为了提供一个统一的事件处理接口,解决浏览器原生事件的兼容性问题,并优化性能。以下是自定义合成事件系统的几个关键原因:
-
跨浏览器一致性: 不同的浏览器对事件的实现存在差异,这可能导致在不同浏览器上运行的代码行为不一致。React 的合成事件系统提供了一个统一的 API,使得开发者可以编写一次代码,而无需担心浏览器兼容性问题。
-
性能优化: React 的合成事件系统允许事件处理在事件冒泡阶段进行,而不是在捕获阶段。这样可以减少不必要的事件处理调用,因为事件在冒泡阶段到达目标元素时,通常意味着用户与页面的交互已经完成。此外,React 还可以将多个事件合并处理,减少对 DOM 的操作次数,从而提高性能。
-
简化事件处理: 在原生事件中,事件处理函数需要处理事件的捕获和冒泡阶段,这可能会导致代码复杂且难以维护。React 的合成事件系统抽象了这些细节,开发者只需要关注事件的冒泡阶段,简化了事件处理逻辑。
-
事件池: React 的合成事件对象是池化的,这意味着在事件处理函数执行完毕后,事件对象会被重用,以减少垃圾回收的压力。这有助于提高应用的性能。
-
安全性和可控性: React 的合成事件系统提供了一个安全的环境,可以防止一些常见的安全问题,如跨站脚本攻击(XSS)。同时,它也使得开发者可以更容易地控制事件的行为。
-
与 React 的生命周期集成: React 的合成事件系统与组件的生命周期紧密集成,例如,事件处理函数可以在组件卸载时自动清理,避免内存泄漏。
-
与 React 的其他特性集成: 合成事件系统与 React 的其他特性(如虚拟 DOM、组件状态管理等)紧密集成,提供了一致的开发体验。
-
便于调试和开发工具: React 的合成事件系统使得开发者可以更容易地调试事件处理代码,因为事件对象具有一致的结构和属性。
综上所述,React 的自定义合成事件系统是为了提供一个更加一致、高效和安全的事件处理机制,使得开发者可以更容易地构建高性能的用户界面。
820.手写瀑布流布局【热度: 551】【JavaScript】【出题公司: 阿里巴巴】
关键词:瀑布流布局
作者备注, 此文章属于转载 原文作者:有机后脑
链接:https://juejin.cn/post/7360534173718167579
来源:稀土掘金
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
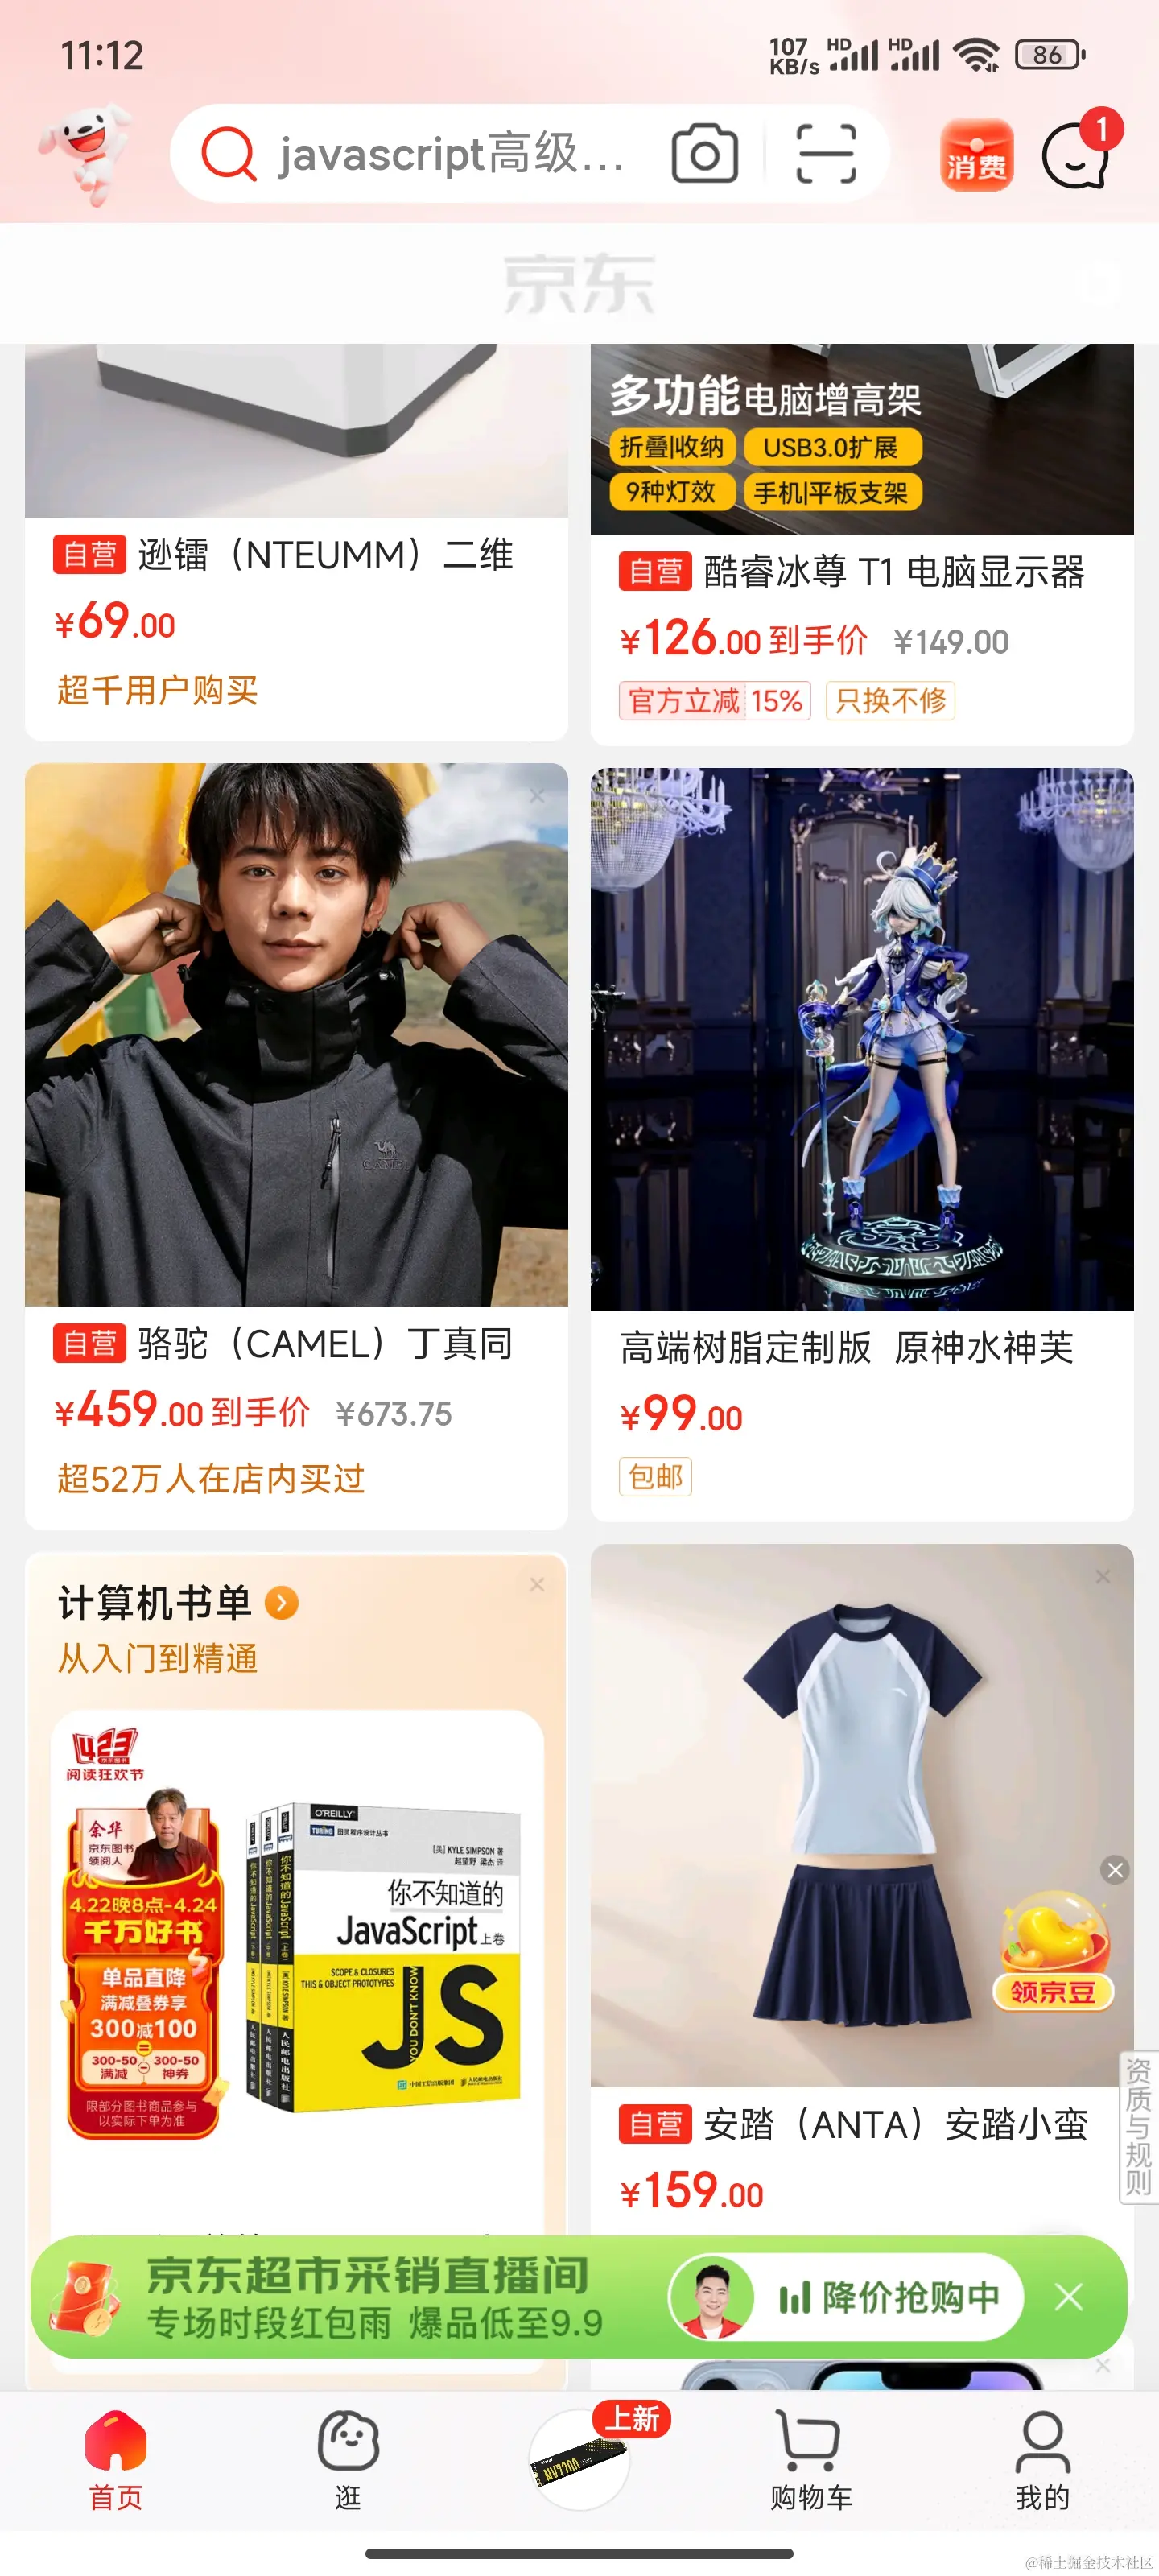
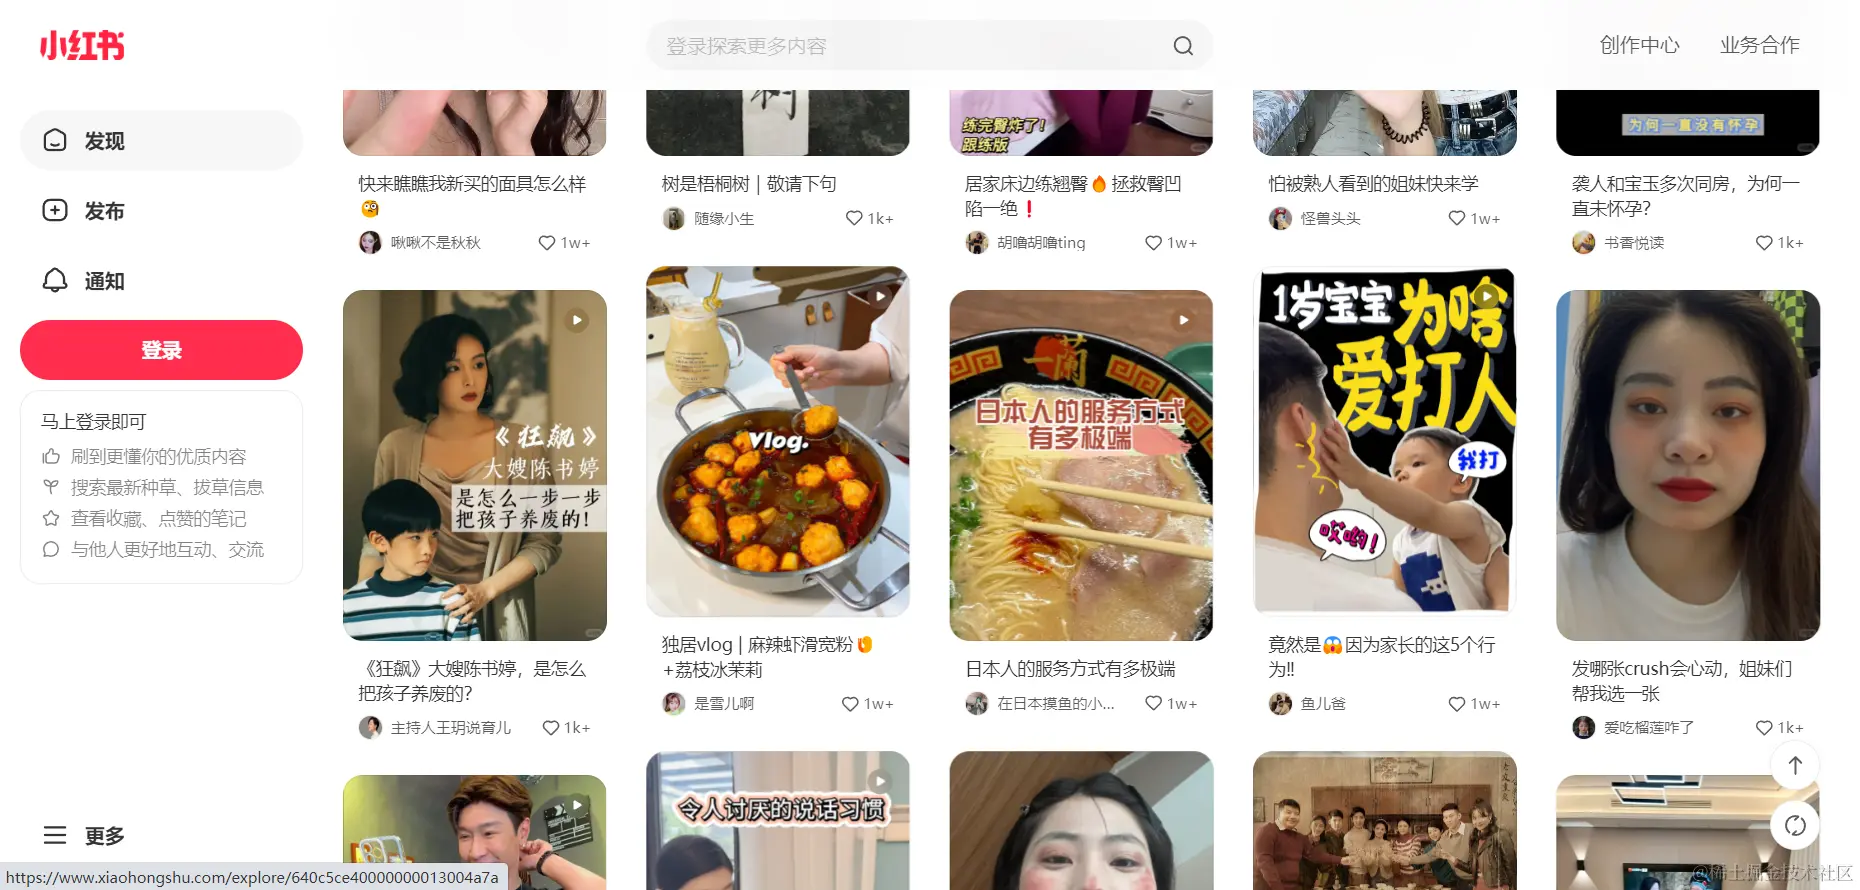
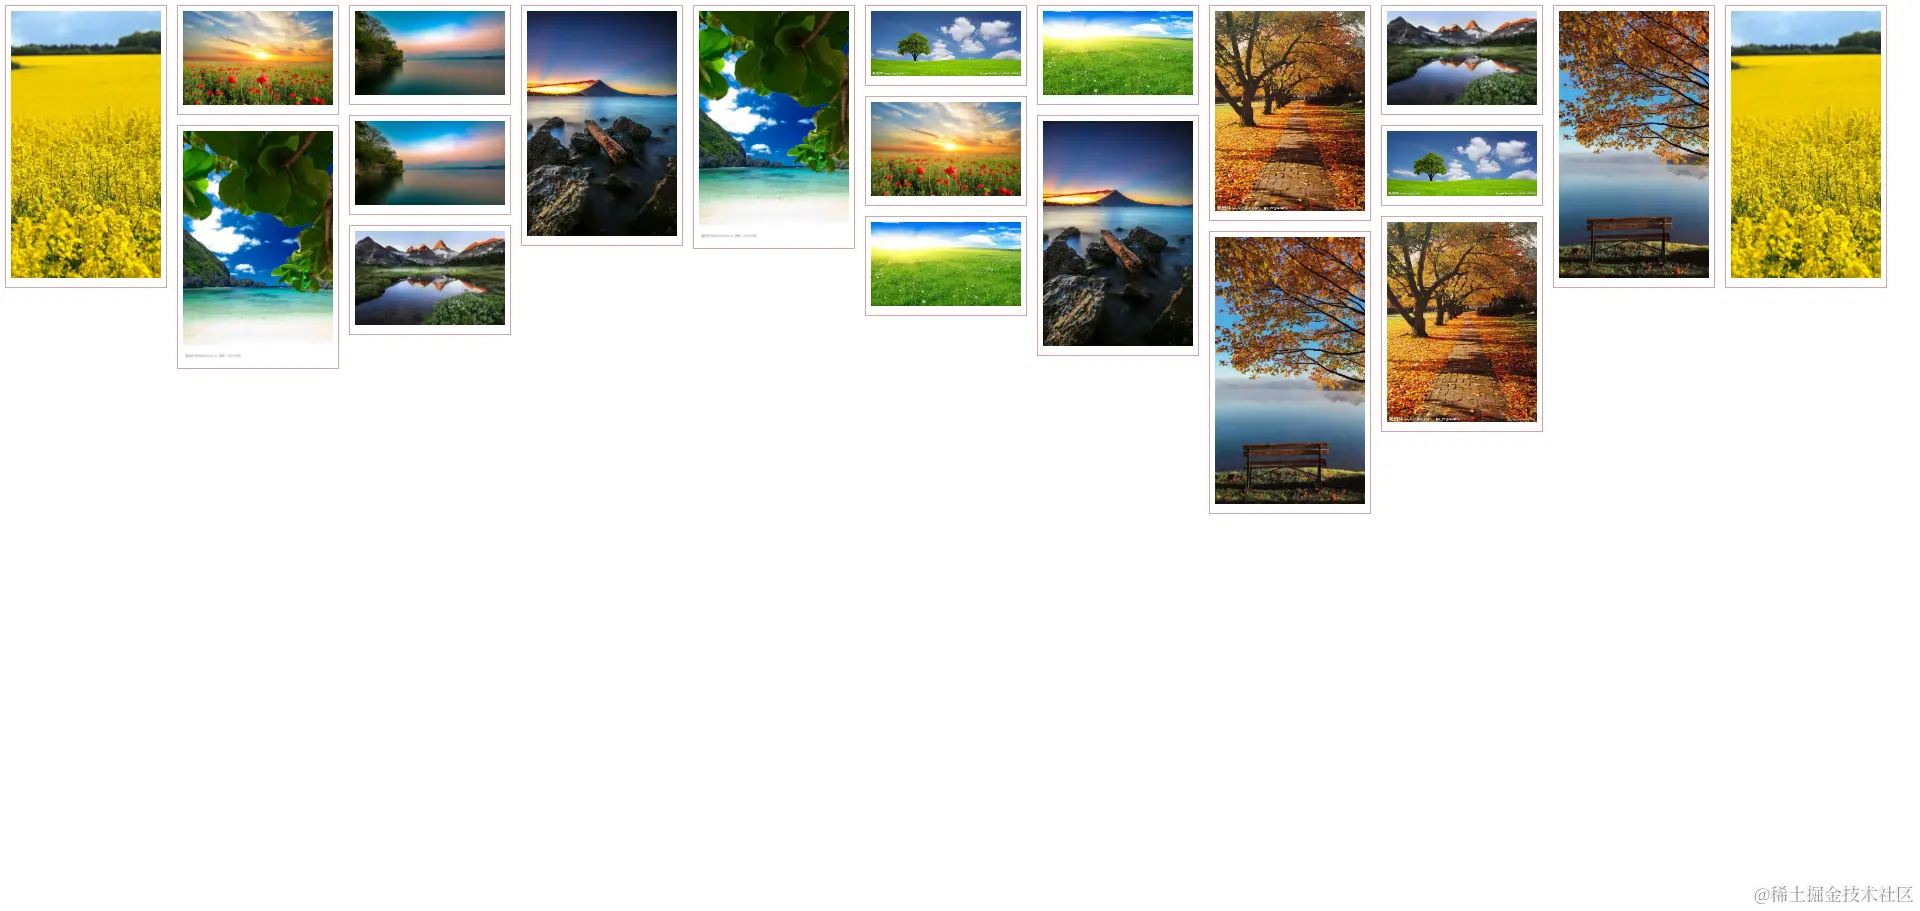
当前主流的一些软件当中我们常常可以看见这样的一种布局,该布局可以将大小不一的图片完整的显示在页面上,并且在杂乱的布局中保持着一定的美感。(如下图:)
- div#container 作为所有图片的容器
- div.box 作为每个图片的容器
- div.box-img 包裹 img 标签
- img 负责显示图片
- 多个 div.box 排列图片
- 重复上述结构,排列了多行图片
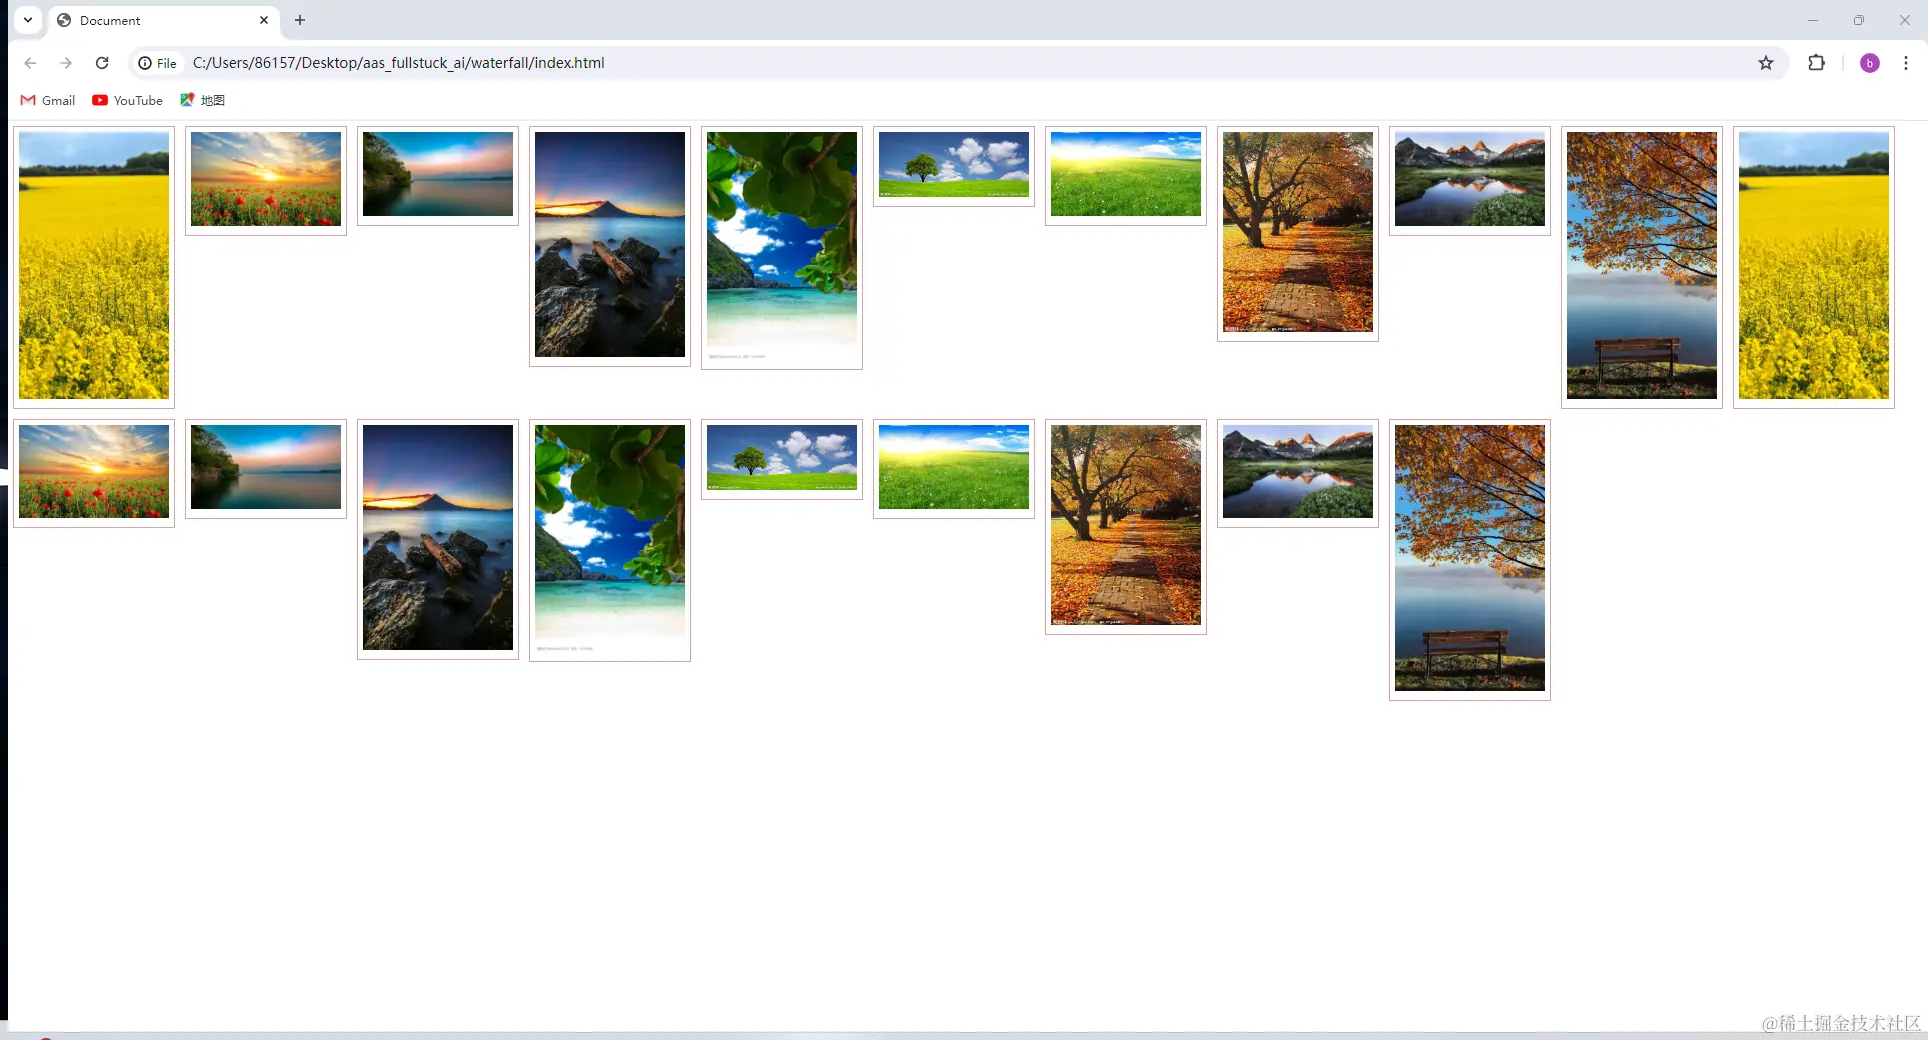
- 主容器使用相对定位占据文档流中的位置而其子标签 box 使用浮动式布局
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8" />
<meta name="viewport" content="width=device-width, initial-scale=1.0" />
<title>Document</title>
<style>
* {
margin: 0;
padding: 0;
}
#container {
position: relative;
}
.box {
float: left;
padding: 5px;
}
.box-img {
width: 150px;
padding: 5px;
border: 1px solid #dd9f9f;
}
img {
width: 100%;
}
</style>
</head>
<body>
<div id="container">
<div class="box">
<div class="box-img">
<img src="./img/1.webp" alt="" />
</div>
</div>
......省略了19个box
</div>
<script src="index.js"></script>
</body>
</html>此时的页面:
1.使用一个父容器 container 包裹子容器 box
2.图片容器 box-img 包裹在容器 box 中,用来展示
3.通过 js 获取父容器的 DOM 结构,再获取其子元素图片容器 box
4.将其按照瀑布流的规则使用绝对定位放置
5.获取屏幕大小计算该屏幕最多能放下几张图片,将前 n 张图片放在第一行
6.使用一个 heightArr 高度数组,在放置的时候记录每一列图片的高度,后面的图片放置在高度最低的那一列
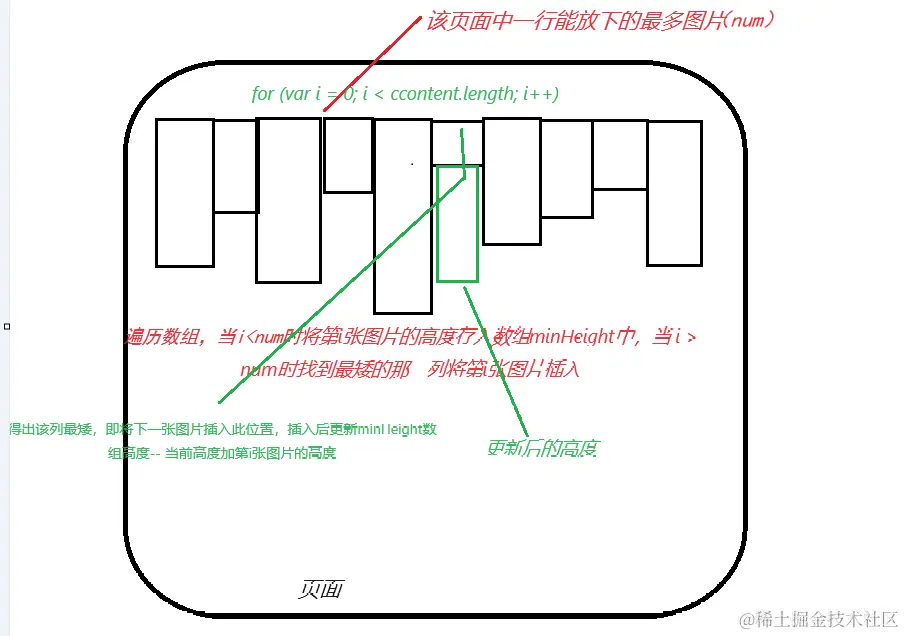
//获取用户屏幕宽度,决定一行几张图
//操作下一张图,放到上一行最矮的列下
imgLocation("container", "box");
function imgLocation(parent, content) {
var cparent = document.getElementById(parent);
var ccontent = getChildElement(cparent, content); //document.querySelectorAll('#container .box')
// console.log(ccontent)
var imgWidth = ccontent[0].offsetWidth;
var num = Math.floor(document.documentElement.clientWidth / imgWidth);
cparent.style.width = `${imgWidth * num}px`;
//要操作的是哪张,每一列的高度
var BoxHeightArr = [];
for (var i = 0; i < ccontent.length; i++) {
if (i < num) {
//记录第一行
BoxHeightArr[i] = ccontent[i].offsetHeight;
} else {
//开始操作,找到最矮的高度及列数
minHeight = Math.min.apply(null, BoxHeightArr);
var minIndex = BoxHeightArr.indexOf(minHeight);
//摆放图片位置
ccontent[i].style.position = "absolute";
ccontent[i].style.top = minHeight + "px";
ccontent[i].style.left = ccontent[minIndex].offsetLeft + "px";
//更新这一列图片高度
BoxHeightArr[minIndex] = BoxHeightArr[minIndex] + ccontent[i].offsetHeight;
}
}
console.log(BoxHeightArr);
}
function getChildElement(parent, child) {
//获取parent中所有child
var childArr = [];
var allChild = parent.getElementsByTagName("*");
//找出所有box
for (var i = 0; i < allChild.length; i++) {
if (allChild[i].className == child) {
childArr.push(allChild[i]);
}
}
return childArr;
}
822.【git] 当项目报错,你想定位是哪个 commit 引入的错误的时候,该怎么做【热度: 650】【web 应用场景】【出题公司: 阿里巴巴】
关键词:二分法查找错误 commit
确实,当你不确定哪个提交(commit)引入了错误时,Git 提供了一个非常强大的工具 git bisect 来帮助你通过二分法快速定位出问题的提交。这个命令通过逐步缩小导致问题的提交范围,最终帮助你找出导致错误的具体提交。使用方法如下:
-
开始 bisect 会话: 打开终端或命令行,切换到你的项目目录下,然后使用命令开始一个 bisect 会话:
-
标记一个坏的提交: 使用下面的命令标记当前最新的提交为'坏'的(假设当前分支上的最新提交包含了错误):
如果你已经知道一个特定的坏提交,可以指定它:git bisect bad [坏的提交id]
- 标记一个好的提交: 接下来,使用以下命令标记一个'好'的提交,即一个没有问题的旧版本:
这个好的提交应该是你确定不包含当前问题的一次提交。
完成以上步骤之后,git bisect 将自动检出一个中间的提交供你测试。你需要编译(如果必要的话)并测试这个版本,然后根据运行结果告诉 Git 这是好是坏:
- 如果这个提交版本没有问题,使用
git bisect good。 - 如果这个提交版本有问题,使用
git bisect bad。
每次你输入结果后,Git 会继续选择另一个提交进行测试,直至找到第一个'坏'的提交。
一旦找到了问题提交,别忘了结束 bisect 会话,释放由 git bisect 占用的资源:
这将会把你的工作目录恢复到 git bisect 开始之前的状态。
- 使用
git bisect时,确保有足够的测试覆盖,以准确判断某个提交是好是坏。 - 一旦找到问题提交,你可以通过查看该提交的详情(
git show [提交id])来了解更多信息,从而帮助你理解为何会引入错误。
https://juejin.cn/post/7232591499069653051
823.axios 是否可以缓存请求返回值到内存里面,下次调用的时候,直接使用内存中的缓存数据?【热度: 884】【网络】【出题公司: 腾讯】
关键词:请求缓存
Axios 本身没有内置的请求缓存机制,但你可以通过一些策略手动实现,或者使用第三方库来帮助你实现请求缓存。以下是实现 Axios 请求缓存的两种方法:
你可以通过创建一个缓存对象和一个自定义的 Axios 实例来实现请求的缓存。每次发起请求前,检查缓存对象中是否已经存在该请求的数据;如果存在,则直接返回缓存数据,否则发起真实的请求,并将请求结果存入缓存对象中。
import axios from "axios";
// 创建一个简单的缓存对象
const cache = {};
const fetchWithCache = async (url, config = {}) => {
// 检查缓存对象中是否已存在请求结果
const cacheKey = JSON.stringify({ url, ...config });
if (cache[cacheKey]) {
return Promise.resolve(cache[cacheKey]);
}
// 发起真实请求
try {
const response = await axios.get(url, config);
// 将请求结果存入缓存
cache[cacheKey] = response;
return response;
} catch (error) {
return Promise.reject(error);
}
};
// 使用 fetchWithCache 函数
fetchWithCache("https://example.com/data")
.then((response) => console.log(response.data))
.catch((error) => console.error(error));有些第三方库如 axios-cache-adapter 可以为 Axios 添加缓存功能,这样你就不需要手动实现缓存逻辑。
import axios from "axios";
import { setupCache } from "axios-cache-adapter";
// 创建 cache adapter 实例
const cache = setupCache({
maxAge: 15 * 60 * 1000, // 设置缓存有效期为 15 分钟
});
// 创建一个带有缓存能力的 axios 实例
const axiosWithCache = axios.create({
adapter: cache.adapter,
});
// 使用带有缓存能力的 axios 实例发起请求
axiosWithCache
.get("https://example.com/data")
.then((response) => console.log(response.data))
.catch((error) => console.error(error));824.手写一个 axios 中间件,支持缓存返回到本地内存【热度: 845】【网络】【出题公司: 腾讯】
关键词:请求缓存
手写一个 axios 中间件, 支持缓存返回到本地内存, 下次同样的请求路径和参数, 直接返回上一次的缓存内容即可, 不需再请求, 同时支持设置自动清除缓存数据的时间。
创建一个简单的 Axios 中间件来支持内存缓存可以大致分为以下步骤:
- 实现一个缓存管理器,可以存储、检索和删除缓存数据。
- 在发送请求前,检查是否存在对应的缓存数据,如果存在,则直接返回缓存数据,而不是发起新的请求。
- 在接收到新的请求响应后,将响应数据存储到缓存中,并设置一个定时器来自动清除过期的缓存数据。
下面是一个简单的实现示例:
import axios from "axios";
class CacheManager {
constructor() {
this.cache = {};
}
// 生成缓存键
_generateCacheKey(url, params) {
const paramString = Object.keys(params)
.sort()
.map((key) => `${key}=${params[key]}`)
.join("&");
return `${url}?${paramString}`;
}
// 设置缓存
set(url, params, data, ttl) {
const cacheKey = this._generateCacheKey(url, params);
// 清除可能存在的旧缓存
if (this.cache[cacheKey]) {
clearTimeout(this.cache[cacheKey].timeout);
}
// 设置新的缓存
const timeout = setTimeout(() => {
delete this.cache[cacheKey];
}, ttl);
this.cache[cacheKey] = { data, timeout };
}
// 获取缓存
get(url, params) {
const cacheKey = this._generateCacheKey(url, params);
return this.cache[cacheKey] ? this.cache[cacheKey].data : null;
}
}
// 创建缓存管理器实例
const cacheManager = new CacheManager();
// 自定义请求拦截器
axios.interceptors.request.use((config) => {
// 检查缓存
const cachedResponse = cacheManager.get(config.url, config.params || {});
if (cachedResponse) {
// 如果找到缓存,将缓存数据作为Promise直接返回
return Promise.reject({
config,
response: cachedResponse,
isCached: true, // 自定义属性,标记这是一个缓存的结果
});
}
return config;
});
// 自定义响应拦截器
axios.interceptors.response.use(
(response) => {
// 存储新的响应数据到缓存。假设 TTL(生存时间)为 1 分钟(60000 毫秒)
cacheManager.set(response.config.url, response.config.params || {}, response, 60000);
return response;
},
(error) => {
// 检查错误对象中是否包含缓存响应
if (error.isCached) {
// 直接返回缓存响应
return Promise.resolve(error.response);
}
// 对于其他类型的错误,继续抛出
return Promise.reject(error);
}
);
// 使用自定义的 Axios 实例发送请求
// 随后的请求(在缓存未过期之前),会直接返回缓存的数据
axios
.get("https://example.com/data", { params: { userId: "123" } })
.then((response) => console.log("Response:", response))
.catch((error) => console.log("Error:", error));这个简单的实现展示了如何在 Axios 请求级别添加缓存逻辑。你可以根据你的实际需求调整和扩展这个实现,比如添加错误处理逻辑、支持更复杂的缓存失效策略等。
831.在低版本的 node 中想使用 es module 该如何做?【热度: 188】【Nodejs】【出题公司: 腾讯】
关键词:node 使用 es module
在低版本的 Node.js 中想要使用 ES Modules (ESM),你主要有以下几种方法。但是,请注意,这些方法或许涉及到一定程度的实验性特性或依赖第三方工具,可能不会像在高版本 Node.js 中那样稳定。
在 Node.js 版本 8.5.0 到 12.17.0 之间,你可以通过启用实验性支持来使用 ES Modules:
- 启动 Node.js 时使用
--experimental-modules标志。 - 文件需要使用
.mjs扩展名,或者在项目的package.json中设置"type": "module"。
例如,通过命令行参数启用:
node --experimental-modules my-app.mjs请注意,这种方法可能会遇到一些 API 兼容性或行为上的差异。
Babel 是一个广泛使用的 JavaScript 编译器,可以将 ES6+ 代码转换为向后兼容的 JavaScript 版本。你可以使用 Babel 来编译使用了 ES Modules 语法的代码,使其能在旧版本的 Node.js 上运行。
配置 Babel 进行转换通常需要以下几步:
- 安装 Babel 相关的依赖:
npm install --save-dev @babel/core @babel/cli @babel/preset-env- 创建一个
.babelrc配置文件或在package.json中添加 Babel 配置,指定预设(presets):
{
"presets": ["@babel/preset-env"]
}- 使用 Babel CLI 编译你的代码:
npx babel src --out-dir dist在这个例子中,Babel 会将 src 目录下的所有文件编译到 dist 目录下,转换后的代码将兼容更早版本的 JavaScript。
如果你的项目使用 TypeScript,你也可以通过 TypeScript 编译器来转换 ES Modules 语法到 CommonJS,从而允许代码在旧版本的 Node.js 上运行。TypeScript 编译设置中有一个 module 配置项,你可以将其设置为 "CommonJS" 来实现转换。
在 tsconfig.json 中配置如下:
{
"compilerOptions": {
"module": "CommonJS"
}
}这样配置后,使用 tsc 编译你的 TypeScript 代码时,它会自动将 ES Modules 转换为 CommonJS 模块。
834.实现一个函数,支持深度遍历 JS 对象,且允许再遍历的时候,修改对象的数据,得到新的对象【热度: 441】【JavaScript】【出题公司: 百度】
关键词:深度遍历对象
实现一个这样的函数,我们需要考虑几个关键点:
- 深度遍历:使用递归遍历对象的所有层级。
- 修改数据:在遍历过程中允许修改对象的数据。
- 返回新对象:保持原对象不变,对每个属性或值进行操作,将修改后的结果存储在新的对象中返回。
以下是一个简单示例,展示了如何实现上述功能:
function deepTraverseAndModify(object, modifierFunction) {
// 验证 object 是对象或数组,否则直接返回
if (typeof object !== "object" || object === null) {
return object;
}
// 如果传入的是数组,遍历数组每个元素
if (Array.isArray(object)) {
return object.map((item) => deepTraverseAndModify(item, modifierFunction));
}
// 初始化一个新对象来存储修改后的对象
const modifiedObject = {};
// 遍历对象的每个属性
Object.keys(object).forEach((key) => {
const originalValue = object[key];
// 判断属性值是否是对象或数组,如果是,递归调用自身,否则直接应用修改函数
const modifiedValue =
typeof originalValue === "object" && originalValue !== null
? deepTraverseAndModify(originalValue, modifierFunction)
: modifierFunction(originalValue, key);
modifiedObject[key] = modifiedValue;
});
return modifiedObject;
}
// 使用示例
const originalObject = {
a: 1,
b: [1, 2, { c: true, d: [3, 4] }],
e: { f: 5, g: 6 },
};
const modifiedObject = deepTraverseAndModify(originalObject, (value, key) => {
// 示例:将所有数字加 10
if (typeof value === "number") {
return value + 10;
}
return value;
});
console.log("Original:", originalObject);
console.log("Modified:", modifiedObject);在这个例子中:
deepTraverseAndModify函数通过递归遍历接受两个参数:要遍历的对象和一个修改函数(modifierFunction),这个修改函数对每个遇到的值进行操作。- 如果当前项是对象或数组,函数会递归调用自身;否则,会对其值应用
modifierFunction函数进行修改。 - 使用
Object.keys()遍历对象属性,并通过映射修改值,确保返回一个新的对象,不会修改原始输入。
通过这种方式,我们不仅可以深度遍历 JavaScript 对象,还能在遍历过程中修改对象的数据,并最终得到一个全新的对象。
如果您觉得这篇文章有帮助,请点个赞吧~
评论
请登录后发表评论
去登录